这个课题在解什么问题
一句话:没有任何一对引物能独自看见整个鱼类群落,而“该选哪几对”过去没有量化答案。
引物选择是 eDNA 监测最大的不确定性
eDNA 从水样里直接扩增短片段来识别物种,比电鱼、拉网更灵敏也更无损。但 PCR 这一步只能用少数几对“通用引物”,而它们在不同水系、不同鱼类区系表现差异极大。
已发表引物多由人工反复观察序列比对图得到——MiFish 就是在 880 种鱼的比对上目视筛出的。主观、难复现,且只测试了全部可能组合中极小的一部分。
用信息熵把“保守”变成可计算的分数
把上千份线粒体基因组比对到同一坐标系,逐位点算 Shannon 信息熵(bits)。熵低 = 该位点跨物种保守 = 适合做引物结合位点;熵高 = 变异丰富 = 适合做种间区分的扩增区。
于是“挑保守区”从人眼判断变成排序问题:引物窗口熵低优先、中间扩增子熵高优先,再用 Primer3 的热力学条件过滤,最后用模拟扩增按实际覆盖度排名。
两对新引物,以及一个更重要的负面结论
新引物 Hui(16S)在基准测试中解析 3,327 个物种,高于全部 13 套已发表引物;Hu(12S)解析 3,124 个。
但真正有价值的是另一半:参考库里约 4,000 个物种中,有数百个没有任何单一引物能解析。实测同样如此——52 个检出物种里只有 21 个被三套引物共同看到。结论不是“换一对更好的引物”,而是必须组合使用,并解决不同引物读数不可直接相加的问题。
AI 在每个环节具体做了什么
这是这一页的主体。我的用法可以概括为一句话:AI 做实现层,我守判断口径。凡是“做出来对不对”可以被测试、被交叉验证的,交给 AI;凡是“这样做算不算数”会直接改变结论的,自己定、并且写进代码注释与论文方法里。下面七个环节逐一拆开,左栏是 AI 承担的部分,右栏是我必须自己下的判断。
问题定义与文献对标
把“通用引物哪对好”变成一个有验收标准的计算问题
AI 承担
- 批量读解 eDNA 引物领域文献,抽取 13 套已发表引物的正反向序列、目标基因、原始出处,整理成结构化表格(后来成为论文 Table 1)。
- 解释陌生工具链:ecoPCR 的匹配规则、Primer3 的热力学参数含义、MAFFT 各比对模式的差异。
- 把散落在不同文献里、口径不一致的“覆盖度”“分辨率”指标,归纳成可以统一实现的定义。
我决定
- 验收标准:能解析到种的数量,而不是“能扩增的数量”——扩增出来但分不清物种,对监测没有意义。这一条决定了后面所有排名。
- 把扩增子长度当作硬约束(100–500 bp),因为 eDNA 是降解的、测序是短读长的。COI 在这个约束下必然吃亏,但这是真实场景。
- 选哪 4 套引物做深入比较:两套新引物 + 最广泛使用的 MiFish_U + 长度最适配短读长的 Tele02。
参考数据库构建
从 NCBI 原始文件到一张干净的鱼类分类表
AI 承担
- 写完
03_reference_db/的四个脚本(524 行):提取鱼类记录、剔除非纯鱼类条目、过滤 NC_ 冗余登录号、补全物种注释。 - 处理 NCBI taxonomy 的各种脏数据:同物异名、亚种命名、缺失层级、编码异常。
- 保证流程保持输入顺序、不做随机采样,让同一份 NCBI 快照重复运行得到逐字节一致的结果。
我决定
- “纯鱼类”的界定边界——哪些条目算污染、哪些冗余登录号该剔除。这直接决定分母(最终 4,045 个数据库物种),分母错了所有比例都错。
- 坚持数据库与筛选流程解耦:参考库单独成模块,日后换一版 NCBI 快照可以整体重跑而不动上游算法。
比对与熵计算
把上千份基因组放到同一坐标系,逐位点打保守度分数
AI 承担
- 实现参考引导的 MAFFT 比对流程,产出 16,575 个位点的全基因组比对。
- 把逐列熵计算改写成 PyTorch 单次批量张量运算,有 CUDA 走 GPU、没有自动退回 CPU——几千条序列 × 一万六千列的计算从“跑一晚上”变成几分钟。
- 叠加基因注释轨道(13 个蛋白编码基因、2 个 rRNA、22 个 tRNA、控制区),按基因汇总平均熵。
我决定
- 熵的状态集必须把 gap 当作第六种状态计入。否则大量缺口的列会被算成“高度保守”,整张熵图会在最不该保守的地方出现假的低谷。这是一个 AI 不会主动替你把关、但会改变全部结论的决定。
- 50 bp 滑动平均只用于看趋势,真正的引物打分回到逐位点原始熵——平滑过的值不能拿来做筛选。
候选引物的穷举与评分
不再靠眼睛挑,而是把所有可能都算一遍
AI 承担
- 在共识序列上穷举全部 20 nt 正向引物 × 反向引物组合,筛出产物 200–350 bp 的配对。
- 接 Primer3 条件做通过/不通过过滤:GC 0.40–0.60、Tm 58–62 °C、发夹熔点 < 40 °C、无简并碱基。
- 实现配对保守度评分
S = exp(−mean(H_f)) × exp(−mean(H_r)),每个基因只保留分数最高的一批,共 2,699 对候选进入下游模拟扩增筛选。 - 并行跑第二条设计路线:先用熵阈值框出保守窗口,再让 Primer3 在窗口内设计 18–25 nt 引物。
我决定
- 热力学条件只做过滤、不做加权打分。把 Tm 和保守度混成一个加权分,权重就成了没人能解释的自由参数——宁可要一个能写进论文方法的简单规则。
- 开第二条设计路线。事实证明是对的:最终表现最好的 Hui 是 21+21 nt,根本不可能出现在只穷举 20 nt 的路线 A 里。单一路线会永远错过它。
- 两条路线各自取最优进入验证,而不是事后挑一个好看的结果。
模拟扩增与同口径基准测试
用两套独立实现互相验证,而不是信任其中任何一套
AI 承担
- 把 Ficetola 等(2010)的扩增判定规则重新实现:每条引物错配 ≤ 3、3′ 末端两个碱基必须完全匹配、简并碱基展开为完整碱基集、产物长度落在窗口内。
- 写出两套彼此独立的实现——筛选阶段用 GPU 批量张量匹配(快,用于 2,699 对候选),基准阶段用 regex 模糊匹配(慢但直观,用于最终 15 套引物)。
- 对每条模拟扩增产物逐条比对参考库,判定是否能唯一确定到种。
我决定
- 不调用 ecoPCR 二进制,而是重实现规则。黑箱能跑出数字,但审稿人问“你的三错配是怎么数的”时,我需要能指着代码回答。可审计优先于省事。
- 两套实现必须在同一批引物上给出一致结论才采信——这是我对 AI 生成代码最主要的验证手段:同一规则、两条独立实现、结果对不上就说明至少有一处错。
- 在仓库 README 里明确写出这两步“看起来重复、实际回答不同问题”,防止后来者误以为可以互相替代。
实地验证与多引物数据整合
三地五批次,以及一个绕不过去的统计难题
AI 承担
- 搭建从原始下机数据到注释丰度表的完整流程:fastp 质控 → VSEARCH 合并去重聚类(97%)→ blastn 比对自建鱼类库 → 逐 OTU 定到最低可信分类阶元。
- 实现锚定校正:以三套引物共同检出的分类单元作内标,算出每个样本的缩放因子,把读数放到同一尺度再合并。
- 实现 Monte Carlo 稀释曲线、Shannon / Gini–Simpson / Pielou 指数、Wilcoxon 符号秩检验 + Holm 多重校正与显著性字母标注。
我决定
- 三地五批次的采样设计、现场执行与时间窗口协调(宁波、银川、北京),89 份水样、267 个“样本×引物”组合中 264 个成功建库。
- 不直接把三套引物的读数相加。三者产出读数差几倍,直接合并会让高产引物的偏好被误读成真实的群落差异。改用共享分类单元做内标——这是方法层面的判断,不是代码问题。
- 设置入选门槛:一个点位必须三套引物都达到 5,000 reads 才纳入分析,30 个点位因此只保留 23 个。宁可样本量变小,不要被近乎空的文库污染结论。
- 明确写明锚定校正只是研究内部的归一化,不等于绝对丰度——不让方法被过度解读。
成图、写作与开源归档
包括主动记录“哪里复现不了”
AI 承担
- 生成论文全部 5 张主图,并按期刊要求反复调整版式、配色、字号与可读性。
- 协助英文写作与逻辑梳理:方法段与代码逐条对齐、结果段的数字回溯到生成它的脚本。
- 整理开源仓库:五个模块目录、统一的
config.py路径解析、每个脚本的--help、大文件走 Release 资产、原始测序数据登记到 NCBI SRA。
我决定
- 在 README 里主动列出三处仓库无法复现已发表结果的缺口,包括某个共识序列文件无法由上游脚本重新生成、路线 B 的模板只能归档不能重算、以及一步人工挑选没有被脚本化。写出来会显得不完美,但让读者自己踩进去才是真的问题。
- 把“结论”和“局限”写成同等篇幅:参考库完整性、只测了三套引物三个水系、锚定校正的假设边界。
关键结果
以下五张图来自投稿中的论文(Water Research,在审)。每张图下面除了图注,还写了我从这张图里读到什么——因为对一个做数据的人来说,能不能把图读成决策,比能不能画出图更重要。
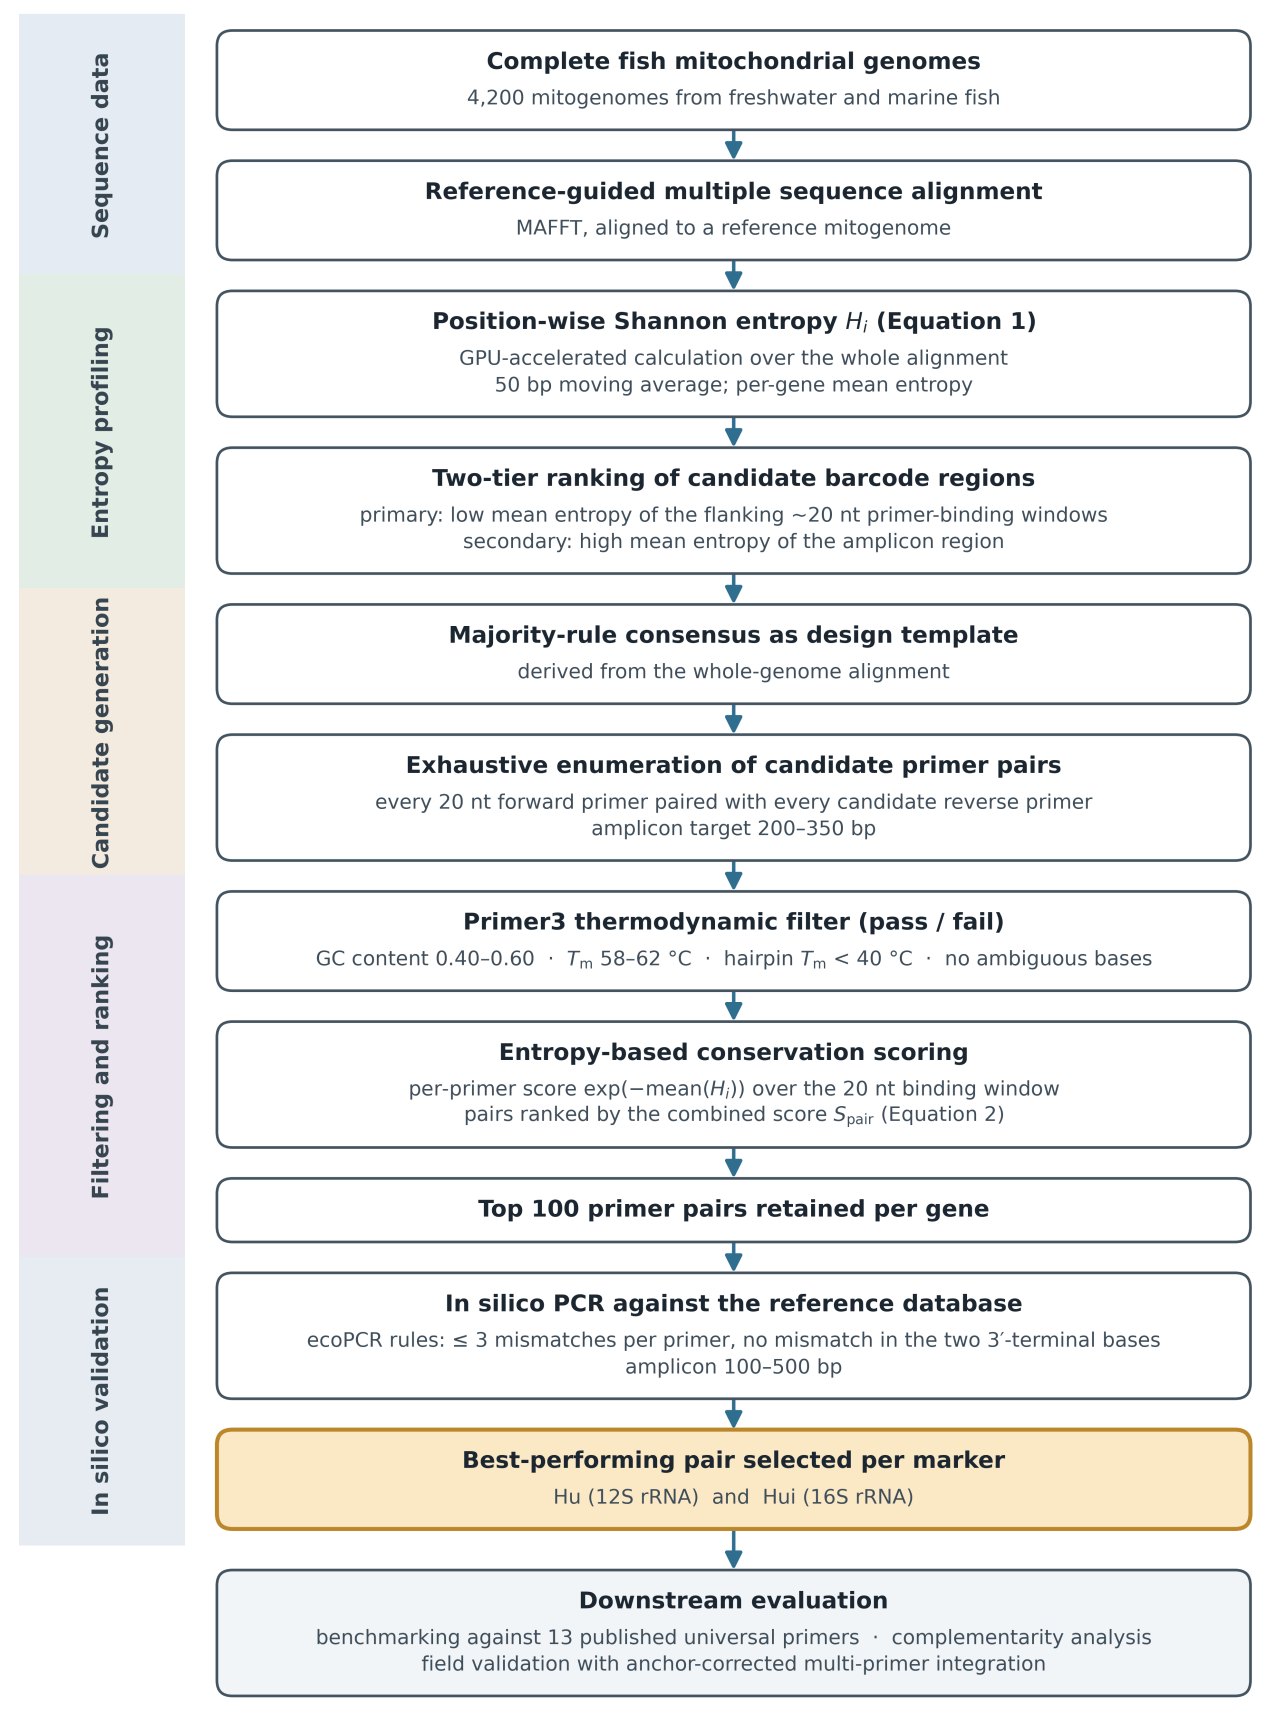
整条流水线:从基因组到两对候选引物
鱼类线粒体基因组经 MAFFT 比对后在 GPU 上逐位点计算 Shannon 熵;候选扩增区按“两侧约 20 nt 引物窗口熵低 + 中间扩增子熵高”双层排序;在多数一致共识模板上穷举的候选引物对先过 Primer3 热力学筛选,再按配对保守度 S 排名;每个基因排名靠前的引物对进入 ecoPCR 规则下的模拟扩增,最终选出 Hu(12S rRNA)与 Hui(16S rRNA)。
这张图本身就是交付物的一部分。流程图上的每一个方框都对应仓库里一个带 --help 的脚本,顺序与编号一致——图、代码、论文方法段三者是同一份东西的三种视图,而不是事后补画的示意。
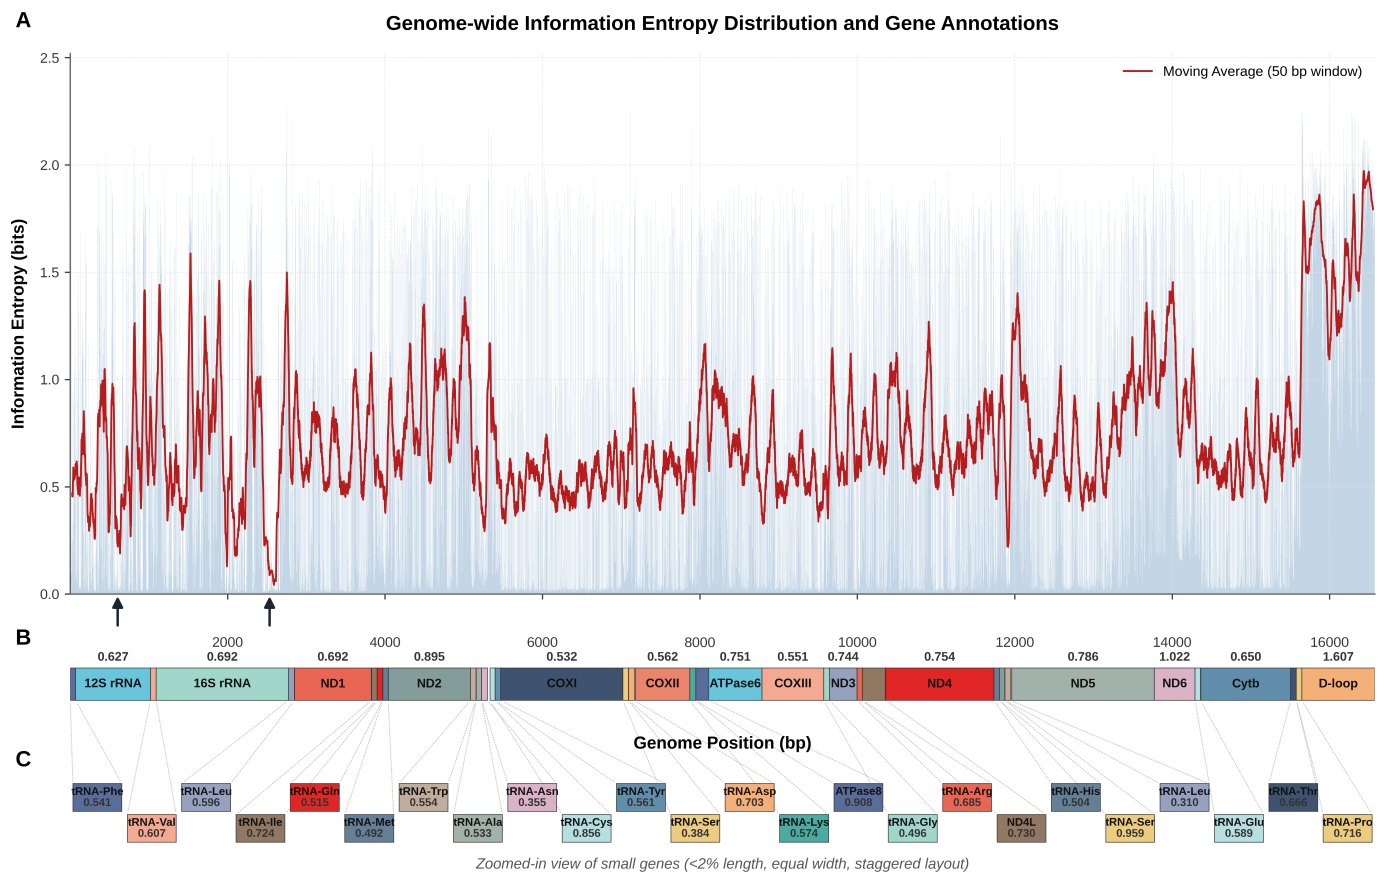
整个线粒体基因组的保守度地图
(A) 灰色为逐位点 Shannon 熵,红色为 50 bp 滑动平均;低熵谷即保守的候选引物结合区,坐标轴下方箭头标出两个入选区域的滑动平均最低点——Hu(12S rRNA,292–628 位,最低点 604)与 Hui(16S rRNA,2,224–2,534 位,最低点 2,534)。(B) 按基因汇总的平均熵,12S 与 16S rRNA 是最保守的主要基因。(C) tRNA 等短片段的放大视图。
12S 平均熵 0.63 bits、16S 0.68 bits,而控制区与 Cytb 都在 1 bit 以上。这解释了一件此前只有经验说法的事:为什么几乎所有鱼类 eDNA 引物都长在 12S 上。人工筛选积累二十年的经验偏好,在这张图上变成了一个可以直接读出来的量化结论。
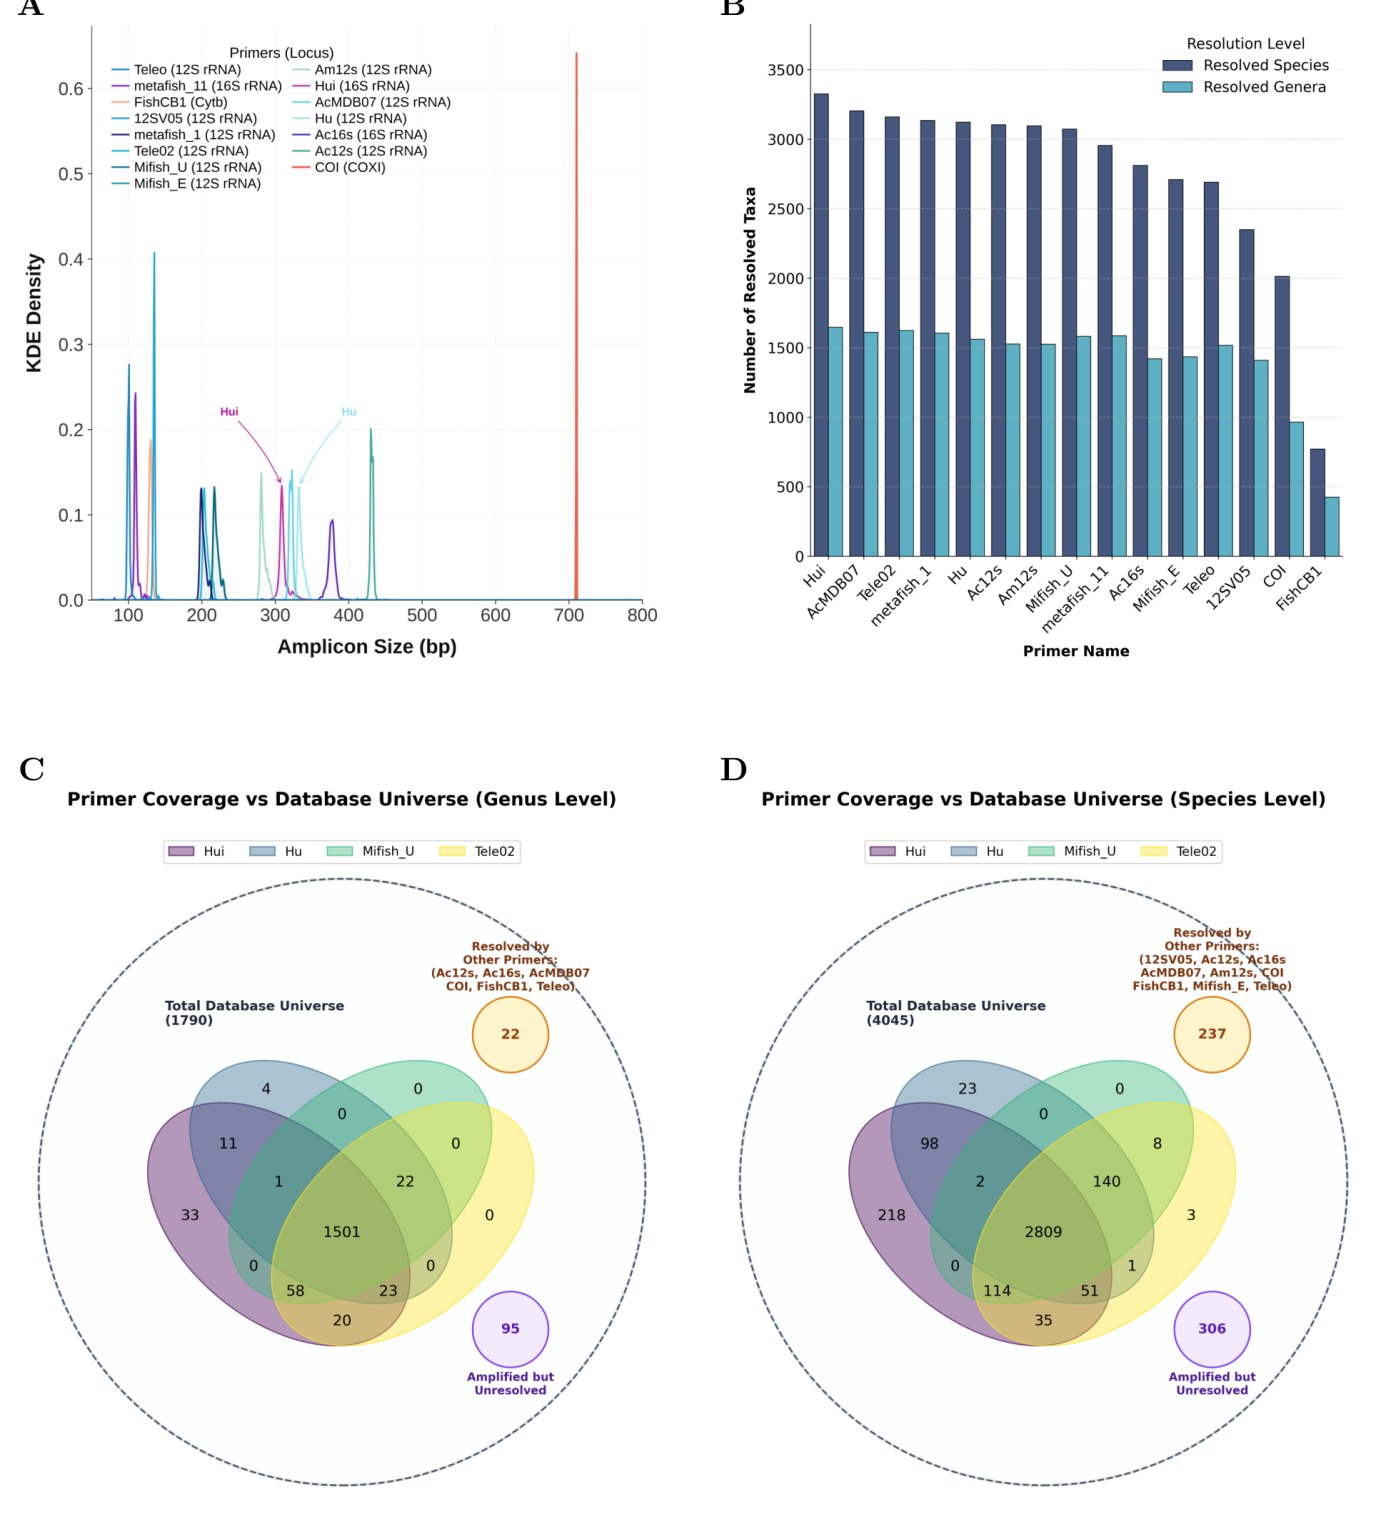
15 套引物在同一把尺子下的对比
(A) 各引物的扩增产物长度分布。(B) 模拟扩增得到的绝对分类学分辨率:可解析到种(深色)与到属(浅色)的数量。(C–D) Hu、Hui、MiFish_U、Tele02 四套主力引物对全库的覆盖,分别为属水平 (C) 与种水平 (D)。
两个数字最值得看。一是 Hui 解析 3,327 种,超过全部已发表引物,说明熵驱动的自动搜索确实能找到人工筛选没找到的东西。二是 D 图里那个更重要的事实:4,045 个物种中,2,809 个是四套引物都能解析的“公共区”,而各自独有的部分(Hui 218、Hu 23、Tele02 3)叠加起来仍然盖不满全库,另有 306 个物种任何一套引物都解析不了。追求“最强单一引物”这条路本身就是错的。
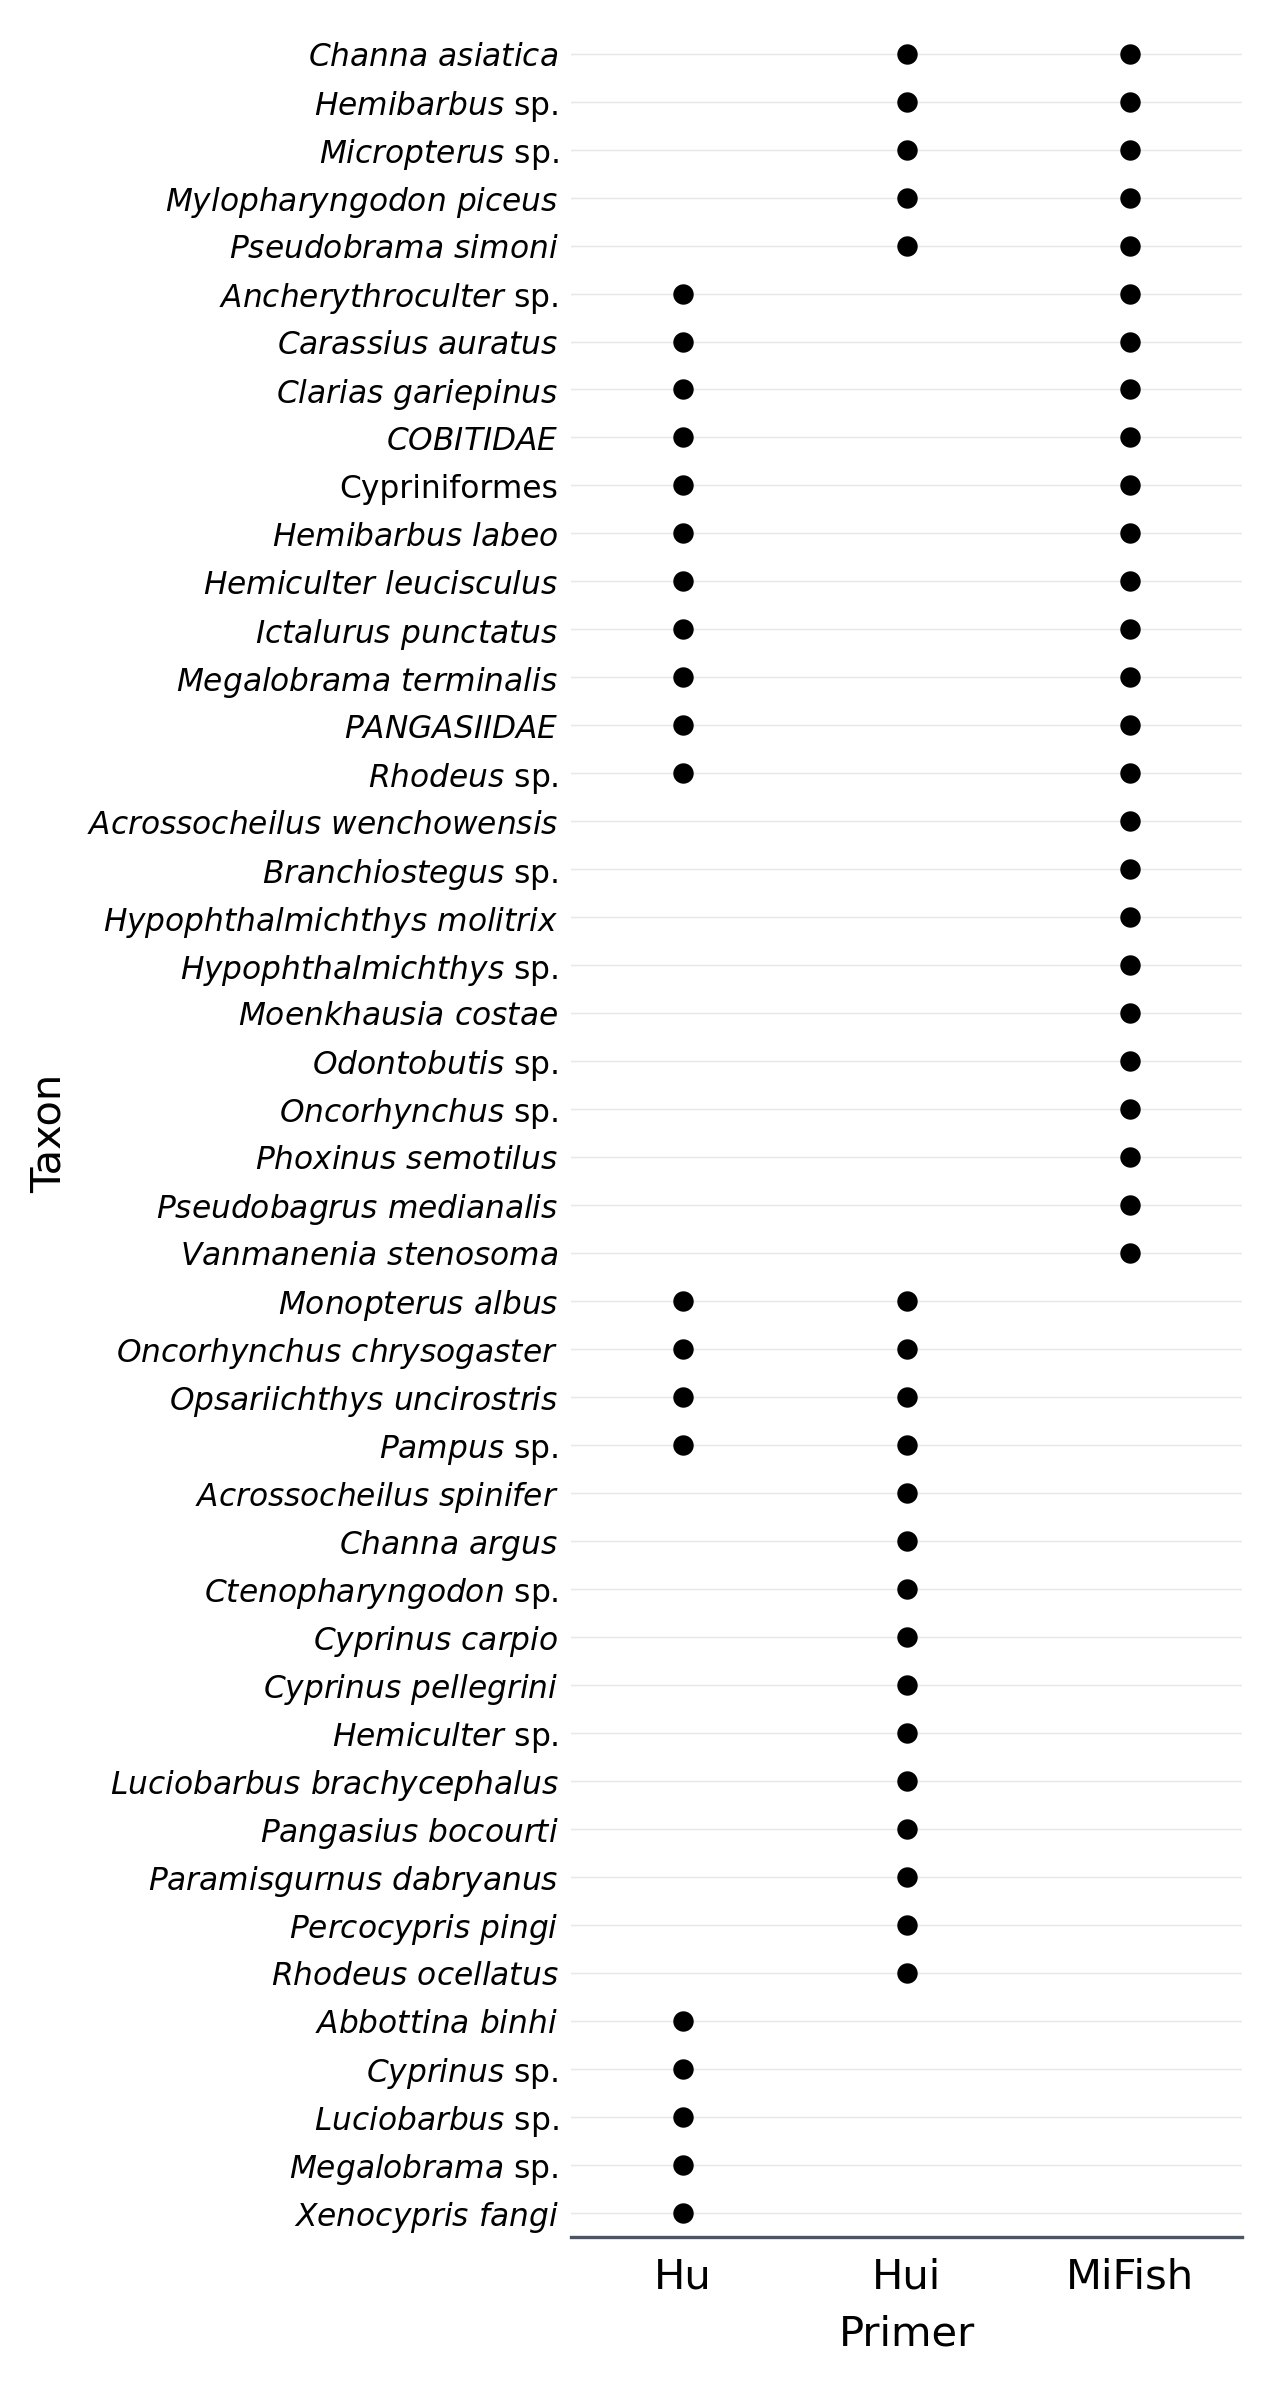
实测数据里的漏检:谁被哪套引物看漏了
三套引物未共同检出的分类单元逐一列出,黑点表示该引物检出。实测共鉴定 52 个物种、79 个分类单元,其中仅 21 个物种、30 个分类单元被三套引物同时检出。
这是全文我最在意的一张图,因为它把“互补性”从统计概念变成了一份具体的名单:鲫、䱗被 Hui 漏掉;月鳢、青鱼被 Hu 漏掉;温州光唇鱼、鲢只有 MiFish 检到。这些都是有渔业与生态管理意义的常见经济鱼类。如果用单一引物做一次常规监测,报告里就会缺掉其中一部分,而且没人会知道缺了——漏检不会报错。
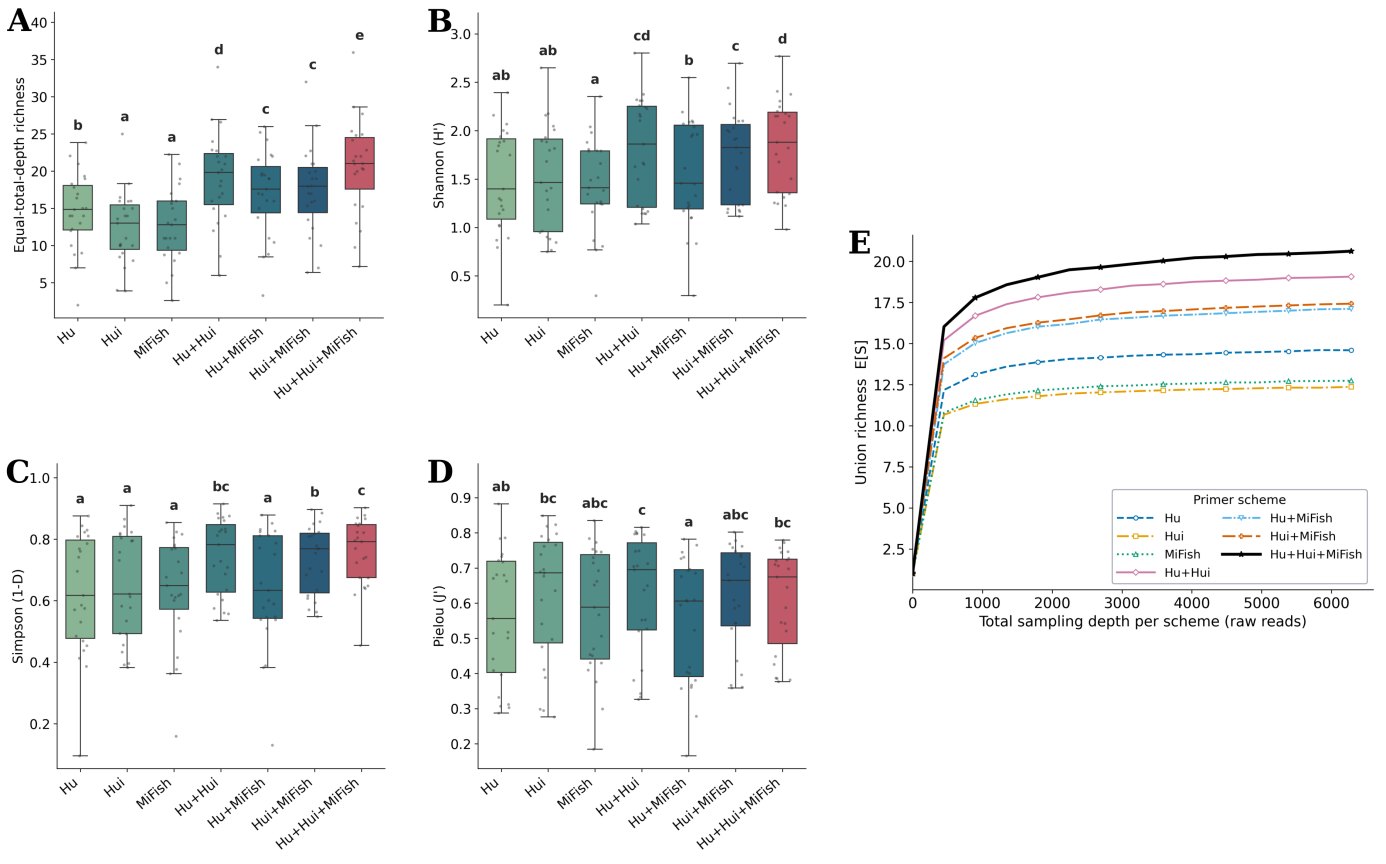
组合之后能多看见多少:一次成本与收益的定量权衡
锚定校正与深度归一化后,七种方案(三套单引物、三种两两组合、一种三引物组合)的 (A) 深度公平丰富度、(B) Shannon 多样性、(C) Gini–Simpson 多样性、(D) Pielou 均匀度,箱线图上方字母为显著性分组;(E) 等效测序深度下union 丰富度的 Monte Carlo 稀释曲线。
读数是这样的:单引物平均 12.3–14.6 个分类单元,两引物 17.1–19.0(Hu + Hui 最好,19.0),三引物 20.6。三引物确实显著更高(配对差 1.59,Holm 校正 p = 1.4×10⁻⁴),但 B–D 三个指标上它与 Hu + Hui 落在同一显著性组——多出来的第三套引物主要贡献稀有物种,不改变群落结构判断。于是有了一个能直接交付的建议:常规监测用 Hu + Hui 两引物,把三分之一的成本省下来;只有在做本底普查、珍稀种搜索或入侵种预警时才值得上第三套。这类“多花的钱买到了什么”的结论,才是监测方真正需要的。
工程与可复现性
课题结束不等于交付结束。整条流水线以 MIT 协议开源,17 个脚本、2,175 行,按研究阶段分成五个模块;大文件走 GitHub Release,原始测序数据登记在 NCBI SRA。判断标准很简单:一个不认识我的人,能不能照着仓库把结果跑出来。
| 模块 | 做什么 | 规模 |
|---|---|---|
| 01_primer_design | 路线 A:比对 → 熵 → 共识 → 穷举设计 → 模拟筛选 → 择优 | 6 脚本 / 722 行 |
| 01b_entropy_threshold_design | 路线 B:熵阈值框定保守窗口 → Primer3 窗口内设计 → 扩增计数 | 3 脚本 / 364 行 |
| 02_in_silico_pcr | 15 套引物的同口径基准与分类学分辨率评估 | 1 脚本 / 281 行 |
| 03_reference_db | 从 NCBI 资源构建鱼类参考分类库 | 4 脚本 / 524 行 |
| 04_amplicon_pipeline | FASTQ → OTU/ASV 表 → BLAST 注释 | 1 流程 / 210 行 |
让别人能跑起来的几个决定
路径统一收口。所有脚本通过 config.py 解析输入输出,设一个 UNIPRIMER_DATA 环境变量就能整体搬迁数据目录,不需要改任何一行脚本。
确定性优先。没有任何一步做随机采样,参考库构建保持输入顺序,同一份 NCBI 快照重复运行得到完全一致的表。
分层存放。小输入(熵谱、基因注释、共识序列、引物表、分类表)进 git;处理后的实测表进 data/field/;68 MB 的比对文件等四份大资产走 Release;原始 reads 留在 SRA(BioProject PRJNA1503226)。
GPU 可选不必需。熵计算与引物筛选有 CUDA 走 GPU,没有自动退回 CPU,读者不会因为没有显卡就卡住。
README 里写明的三处“跑不出来”
仓库 README 有一节叫 Where the archive does not reproduce the published tables,逐条写出三个缺口:某个 16,575 位点的共识序列文件无法由上游脚本在任何参数下重新生成;路线 B 的设计模板与熵谱只能归档、不能从路线 A 的比对重算;路线 B 中间有一步人工挑选没有被脚本化。
把这些写出来,仓库看起来当然没那么完美。但复现性的意义在于让下一个人少踩坑,而不是让作者好看——没写出来的缺口,只会变成别人浪费掉的一整天。这一条同样适用于任何交付给他人使用的数据流程。
我沉淀下来的六条方法论
这些不是使用技巧,是在这个课题里付过代价才换来的判断。它们和具体做什么领域无关。
一、先定验收标准,再让 AI 写代码
“引物好不好”如果不先收敛成“能解析到种的数量”,AI 可以给出十种都说得通的评价方式,而你没有办法判断哪个对。标准定不下来的时候,写出来的代码越多越危险——因为它会让你误以为问题已经在解决了。
二、同一规则写两套独立实现,交叉验证
AI 生成的代码最危险的不是报错,而是安静地跑出一个看起来合理的错数字。本课题里同一套扩增判定规则被实现了两次——一次 GPU 张量匹配,一次 regex 模糊匹配——两者结论一致才采信。这比逐行审代码更省力,也更可靠。
三、判断口径永远自己下,并且写进代码注释
gap 算不算第六种状态、5,000 reads 的入选门槛、热力学条件只过滤不加权——这些决定不是技术问题,而是会直接改变结论的问题。AI 不会主动提醒你这里有个岔路口。我的做法是:每一个这样的决定都写在脚本 docstring 的第一段里,让它和代码一起被审阅。
四、宁可重实现规则,也不调用黑箱
现成的 ecoPCR 二进制能直接跑出数字,但没法回答“你的错配是怎么数的”。把规则重实现一遍虽然多花时间,却换来每一个数字都能追到某一行代码。凡是结论要被别人质询的场景,可审计性的价值远高于省下来的那点时间。
五、并行开第二条技术路线,成本很低、回报可能极高
有了 AI 之后,多开一条路线的成本从“再花两个月”降到“再花两天”。这个课题里第二条路线的产出就是最终表现最好的 Hui——它是 21+21 nt,在只穷举 20 nt 的第一条路线里根本不可能出现。单路线不是慢,是会系统性地错过某一类答案。
六、把失败与缺口显式归档
仓库 README 里专门有一节写“哪里复现不出已发表结果”。负面信息主动写出来,短期看是自曝其短,长期看是让这份交付物真的能被别人用起来的前提。同一条逻辑适用于任何要移交的模型、流程或数据管线。
这套做法可以迁到哪里
抽掉生物学,这个课题的骨架是一个相当通用的问题形状:高维观测数据 → 指标该怎么定 → 方案空间穷举与评分 → 多来源数据尺度不一致 → 用多少成本买到多少信息量 → 交付一套别人能接手的流程。
在海量候选方案里找最优组合
“从 2,699 对候选中按量化分数收敛到 2 套”这件事,换成工艺参数组合、配方筛选、传感器布点方案、供应商组合,结构完全一样:定义可计算的评分 → 穷举而非凭经验挑 → 用独立方法复核排名。
多来源数据尺度不一致时怎么合并
三套引物读数差几倍不能直接相加,和不同厂区、不同批次、不同型号仪器的监测数据不能直接汇总是同一个问题。用共同覆盖的部分当内标反推缩放因子,不需要外部标准品——这个思路可以直接搬。
论证“多花的这笔钱买到了什么”
三引物比两引物多检出 1.59 个分类单元、显著但只影响稀有种——这类结论直接决定预算怎么花。任何监测体系、检测频次、冗余设备的投入决策,都需要有人把它算成这样一句话。